STM32H7,MPU和Cache使用场景
为什么使用Cache才能充分发挥CPU的性能?
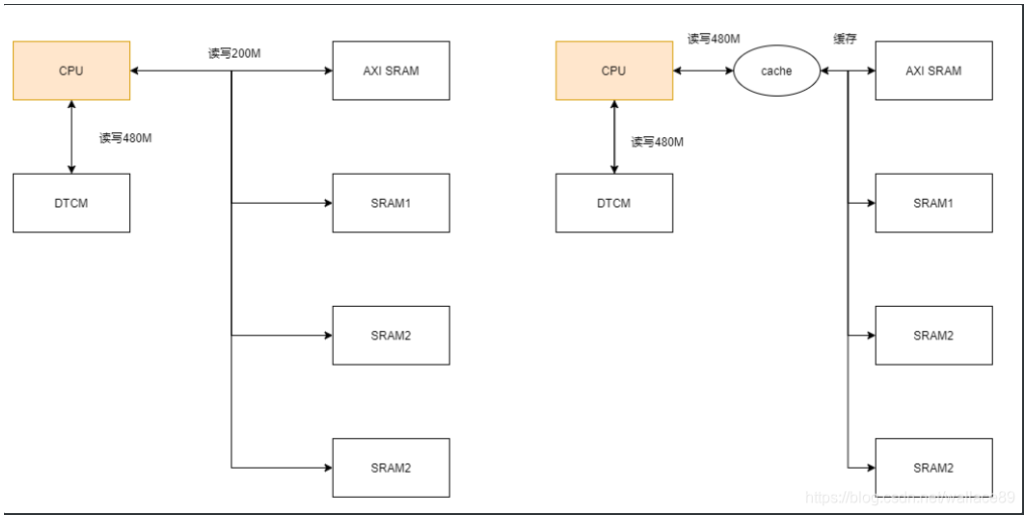
在默认的配置下,静态内存优先使用128KB的DTCM。原因是CPU读写DTCM内存的速度是480M,所以一般优先使用128KB的DTCM。CPU直接读写其他静态内存的速度仅仅只有200M,白白浪费CPU的480M主频了。为了解决这个问题,Cortex-M7架构有了cache。通过提前将数据缓冲到12KB的cache,然后CPU再从cache里读取数据,这样就能解决当CPU读写AXI SRAM与SRAM等内存时所造成的性能损失。
为什么要学习使用MPU?
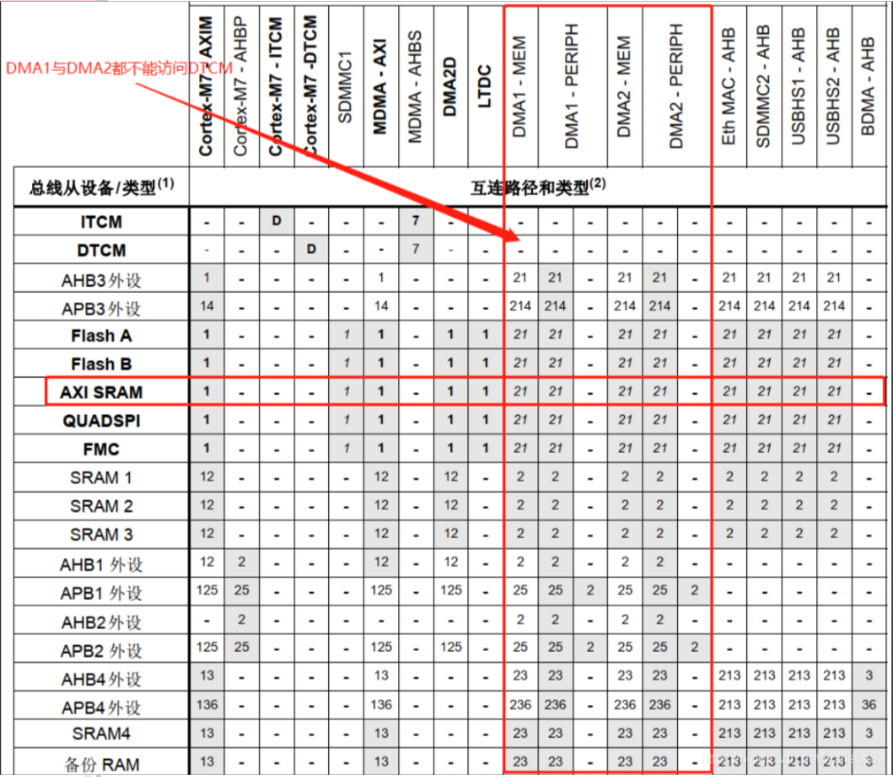
通过配置MPU,能够配置并正常使用CPU的cache。最常用的情景是ADC+DMA采集模拟量数据。因为DMA并不能将外设采集的模拟量数据存放到DTCM里,一般只能放进AXI SRAM、SRAM1、SRAM2、SRAM3里。此时,就需要使用MPU+cache提高CPU读写AXI RAM,SRAM等内存的速度。
MPU和Cache是如何配置的?
最简单的方法是使用STM32 CubeMX配置,可以将MPU的设置分为三部分。第一部分是配置MPU的内存地址,第二部分是配置Cache的读写规则,第三部分设置保护规则(配置MPU是为了使用Cache,所以不用保护)。
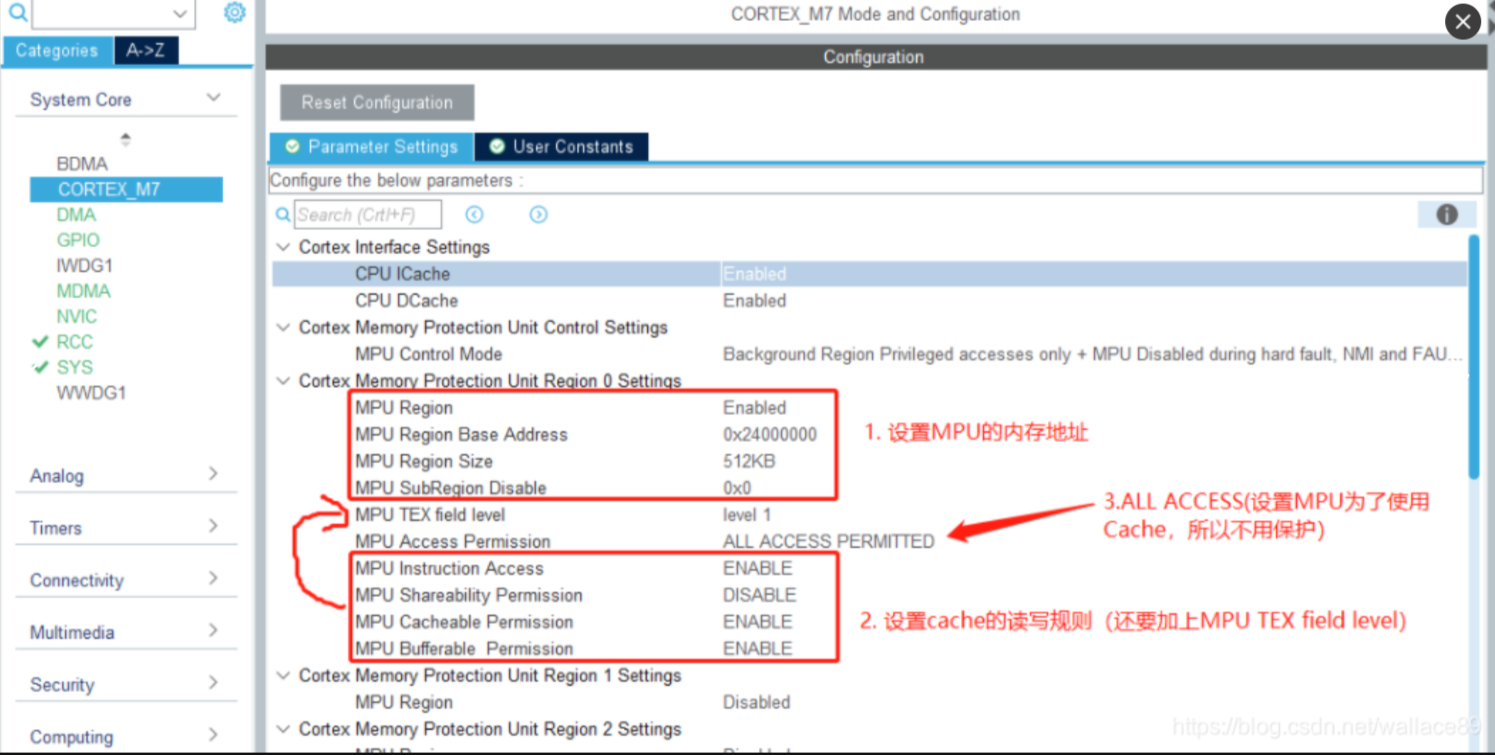
CubeMX的MPU和Cache配置界面如下:
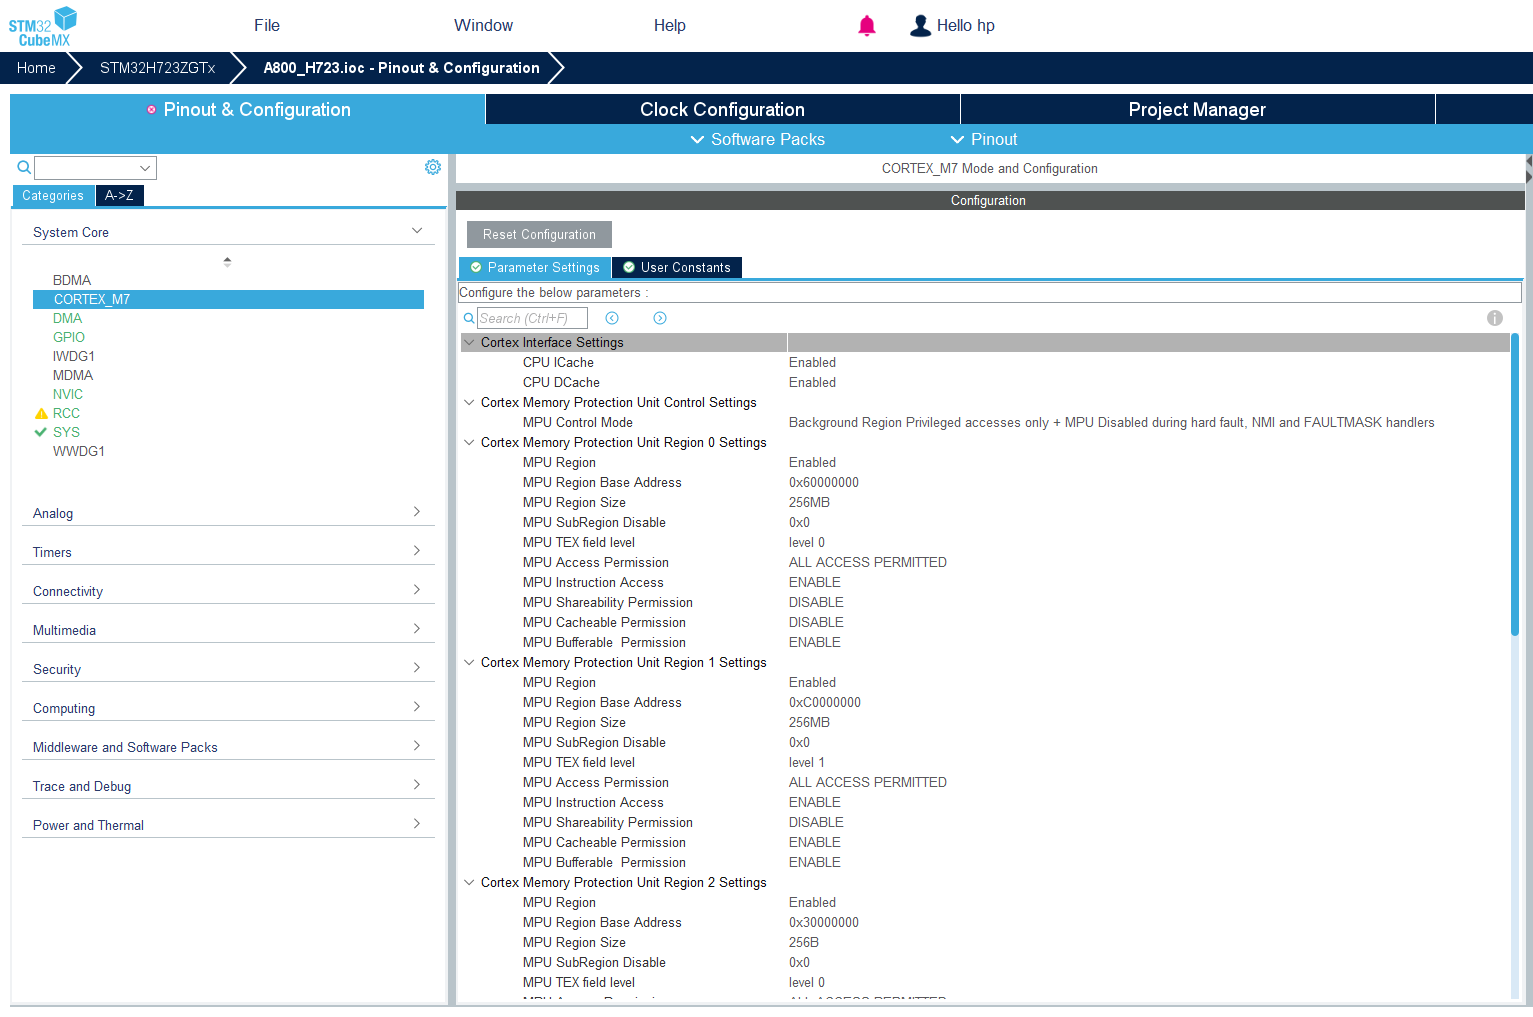
界面中配置项与寄存器对应关系如下:
| 配置项 | 寄存器 | 说明 |
|---|---|---|
| CPU ICache | 内核CCR寄存器bit17,名称IC, | 使能1级指令缓存 |
| CPU DCache | 内核CCR寄存器bit16,名称DC, | 使能1级数据缓存 |
| MPU Control Mode | 内核MPU_CTRL寄存器 | 使能MPU,使能默认存储映射作为背景域,hardfault、NMI和FAULTMASK中断时MPU不使能 |
| MPU Region | 内核MPU_RNR寄存器 | 使能某个保护域 |
| MPU Region Base Address | 内核MPU_RBAR寄存器 | 保护域的基地址 |
| MPU Region Base Size | 内核MPU_RASR寄存器SIZE | 保护域的大小 |
| MPU SubRegion Disable | 内核MPU_RASR寄存器SRD | 子域不使能 |
| MPU TEX feild level | 内核MPU_RASR寄存器TEX | 访问等级 |
| MPU Access Permission | 内核MPU_RASR寄存器AP | 访问许可 |
| MPU Instruction Access | 内核MPU_RASR寄存器XN | 指令访问使能 |
| MPU Shareability Permission | 内核MPU_RASR寄存器S | 共享许可 |
| MPU Cacheable Permission | 内核MPU_RASR寄存器C | cache许可 |
| MPU Bufferable Permission | 内核MPU_RASR寄存器B | 暂存许可 |
CPU的内存访问类型、Cache策略是什么?
CPU的内存访问类型有Normal、Device、Strongly-ordered。
Cache策略有Non-cacheable、Write through、Write back and no write allocate、Write back and write allocate。
其中只有内存访问类型Normal支持以上4种Cache策略。内存访问类型和Cache策略的使用是通过配置MPU和Cache来实现的。
怎么实现不同内存访问类型和Cache策略呢?
| 内存访问类型 | Cache策略 | 配置方法 | 说明 |
|---|---|---|---|
| Normal | Non-cacheable | 指令访问使能,共享不使能,TEX为level1,cache不使能,buff不使能 | 无缓冲 |
| Normal | Write through | 指令访问使能,共享不使能,TEX为level0,cache使能,buff不使能 | no write allocate, read allocate,透写,写不开辟cache,读开辟cache |
| Normal | Write back and no write allocate | 指令访问使能,共享不使能,TEX为level0,cache使能,buff使能 | no write allocate, read allocate,回写,写不开辟cache,读开辟cache |
| Normal | Write back and write allocate | 指令访问使能,共享不使能,TEX为level1,cache使能,buff使能 | write allocate, read allocate 回写,写和读都开辟cache |
| Device | 无 | 指令访问使能,共享不使能,TEX为level0,cache不使能,buff使能 | 有序访问(如ETH MAC的tx/rx描述符缓存区) |
| Strongly-ordered | 无 | 指令访问使能,共享无关,TEX为level0,cache不使能,buff不使能 | 强有序访问 |